L2 Cache + Set-Associative
Verilog Pipelining + L1 Cache에서 Set-Associative 사용 및 L2 Cache 얹기
Intro
L1 Cache 구현 후 두 번째로 받은 과제가 바로 L1 Cache를 기존 direct-mapped에서 tree-based Pseudo LRU를 replacement policy를 사용하는 set-associative로 바꾸기 및 split L1 Cache와는 다른 shared L2 Cache 구현하기였다.
원래 일주일 안에 다 하기로 했는데, 하필 첫 이틀 동안 연구실 서버 연결하랴, Neovim 공부하랴, 날려먹게 되어서 결국 이틀을 더 오버하게 되었다.
확실히 저번 과제 이후로 이해도가 조금 늘어 디버깅도 빠르고 코딩도 빨라진 것 같다. 아직 의문점이나 제대로 이해하지 못한 부분이 어렴풋이 존재함을 느끼지만 괜찮다. 더 나아져보자!
Set-Associative
우선은 L1 Cache 또한 Set-Associative로 바꿔야 했고, L2 Cache도 기본적으로 L1 Cache를 베이스로 할 것이기 때문에 L1 Cache를 Set-Associative로 바꿔주는 것 먼저 하기로 했다.
우선 구현하고자 한 Set-Associative 상세는 다음과 같다.
- 4-way
- Write-Back, Write-Allocate
- Pseudo LRU
그래서 해야하는 일은 기존 L1 Cache에 SET을 추가해주면서 상수 파라미터 값을 조금 수정해주고, FSM에 state를 추가하고, Pseudo LRU를 구현하는 것이었다.
I-Cache
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
    // FSM state
    localparam IDLE       = 3'b000; // 0
    localparam BUFF       = 3'b001; // 1
    localparam PLRU       = 3'b010; // 2
    localparam MEM_REQ    = 3'b011; // 3
    localparam RESPOND    = 3'b100; // 4

    // Set-Associative
    reg               hit;        // is hit?
    reg [WAY_NUM-1:0] hit_way;
    reg               empty;      // is there a empty way?
    reg [WAY_NUM-1:0] empty_way;
    reg [WAY_NUM-1:0] target_way; // need replacement in target_way

    // Pseudo LRU
    reg [WAY_NUM-2:0] PLRU_entries[0:SET_SIZE-1];
그래서 state에 BUFF, PLRU가 추가되었다. BUFF state는 IDLE state에서 HIT을 검사해 hit_way를 설정하는데, non-blocking 특성상 한 사이클이 딜레이되어야 해서 생기게 되었다. PLRU는 Pseudo LRU의 준말이며 PLRU를 업데이트하거나 PLRU를 확인해서 target_way를 설정하는 state이다.
만약 non-blocking이 아니라 blocking으로 했다면 딜레이를 안 해도 됐을까? 아직 해당 부분에 대해 완전히 이해하지 못한 것 같아서 아쉽다. 아마 며칠이고 앓으면서 이것저것 해보면 깨달을지도 모르겠다. 다음 과제에서 한 번 도전해볼까?
D-Cache
D-Cache도 근본적으로 방법은 I-Cache와 완벽히 동일하지만, 타이밍상 write와 dirty bit 검사 때문에 문제가 있어 세밀하게 조정해줄 필요가 있다.
그래서 RESPOND때 하는 write 때문에 hit/hit_way, empty/empty_way/target_way를 RESPOND state 때 초기화해주어야 하고, dirty bit 검사를 위해 BUFF2 state를 넣어야한다.
1
2
3
4
5
6
7
    localparam IDLE       = 3'b000; // 0
    localparam BUFF       = 3'b001; // 1
    localparam PLRU       = 3'b010; // 2
    localparam BUFF2      = 3'b011; // 3
    localparam MEM_REQ    = 3'b100; // 4
    localparam EVICT      = 3'b101; // 5
    localparam RESPOND    = 3'b110; // 6
tree-based Pseduo LRU
컴퓨터구조론 수업 시간에 배웠던 replacement policy 중 하나였다. 배울 때는 아주 신선한 방법에 놀랄 노자였지만 구현하는 것은 정말정말 쉬워서 더 놀랐다. 물론 PS 짬밥 때문이겠지만…
그래도 처음에 flip에 꽂혀서 무작정 flip해버리기도 했지만 chatGPT의 도움으로 왜 잘못됐는지 알아냈다. 사실 pseudo LRU 같은 경우 말 그대로 캐시 conflict 시 어떤 블럭을 evict할지 정하는 replacement policy이기 때문에, 알고리즘적으로 원하던 것과 다르게 구현해도 테스트벤치에서 티나지 않는다.
그러니 모 사이트에서처럼 맞았습니다!!나 틀렸습니다를 명확하게 알 수가 없어 확실히 문제점도 인지 못한다는 점이 힘들었다. 아마 조금이라도 더 복잡한 알고리즘 내지 자료구조를 사용했다면 그야말로 재앙이었을 것 같다.
pseudo LRU는 기존 LRU 즉, Least Recently Used를 좀 더 coarse-grained하게, 말 그대로 pseudo 임을 이용한 알고리즘이라고 할 수 있다.
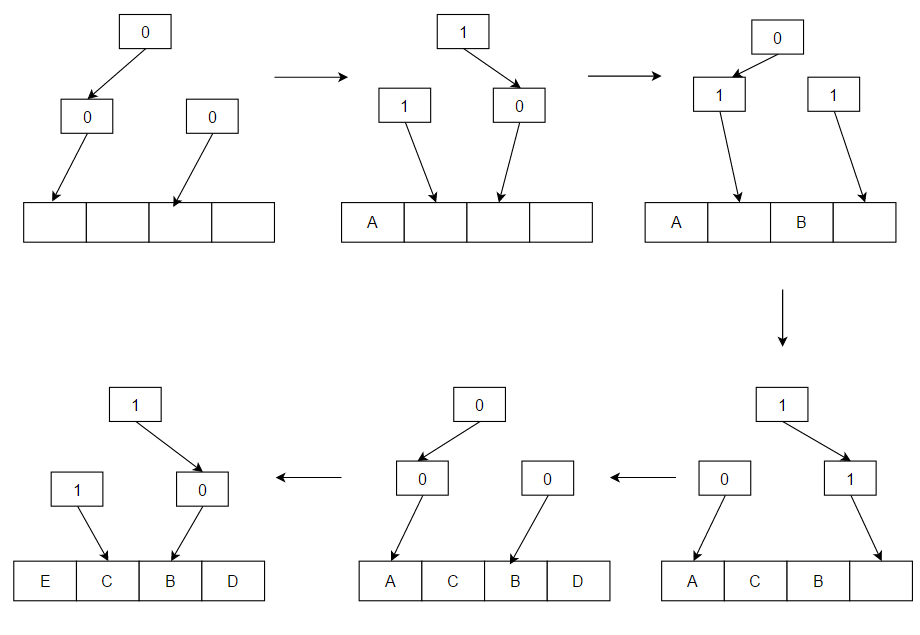
그림에서 0이면 오른쪽이 최신 블럭, 1이면 왼쪽이 최신 블럭을 가리키게 된다. 반대로, 0이면 왼쪽이 가장 오래된 블럭, 1이면 오른쪽이 가장 오래된 블럭이므로 이를 이용해 다음에 어떤 걸 교체할지 선택할 수 있다.
Least Recently Used라는 말 그대로, 이제 저 0과 1을 이용해서 가장 오래된 블럭을 victim으로 삼으면 된다.
보면 알 수 있듯, A라는 블럭을 올리고 싶을 때 맨 위에 있는 0을 보고 왼쪽으로, 그 다음 0을 보고 왼쪽으로 가서 첫 번째 슬롯에 A를 쓰게 된다.
이후 이 A 블럭이 가장 최근에 사용된 것이므로 이에 맞도록 비트들을 바꿔준다.
다음 B 블럭이 들어올 때, 마찬가지로 차근차근 1이니까 오른쪽, 0이니까 왼쪽에 접근해서 써주고, 이제 이 B 블럭이 가장 최신 블럭이 되도록 만들어준다.
이 알고리즘은 말 그대로 진짜 LRU임을 보장하지는 않지만, 진짜 LRU에 비해 구현이 간단하면서도 충분히 효과적인 결과를 내기 때문에 많이 사용한다고 한다.
Pseudo LRU 부분의 코드는 다음과 같다. 편의를 위해 Pseudo LRU와 관련되지 않은 기타 코드는 생략했다.
코드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
PLRU: begin
	if(hit) begin
		case(way)
		0: begin
			PLRU_entries[parsed_set][0] <= 1;
			PLRU_entries[parsed_set][1] <= 1;
		end
		1: begin
			PLRU_entries[parsed_set][0] <= 1;
			PLRU_entries[parsed_set][1] <= 0;
		end
		2: begin
			PLRU_entries[parsed_set][0] <= 0;
			PLRU_entries[parsed_set][2] <= 1;
		end
		3: begin
			PLRU_entries[parsed_set][0] <= 0;
			PLRU_entries[parsed_set][2] <= 0;
		end
		endcase
		state <= RESPOND;
	end
	else if(empty) begin
		case(way)
		0: begin
			PLRU_entries[parsed_set][0] <= 1;
			PLRU_entries[parsed_set][1] <= 1;
		end
		1: begin
			PLRU_entries[parsed_set][0] <= 1;
			PLRU_entries[parsed_set][1] <= 0;
		end
		2: begin
			PLRU_entries[parsed_set][0] <= 0;
			PLRU_entries[parsed_set][2] <= 1;
		end
		3: begin
			PLRU_entries[parsed_set][0] <= 0;
			PLRU_entries[parsed_set][2] <= 0;
		end
		endcase
		state <= MEM_REQ;
	end
	else begin
		// replacement
		// way selection & update
		if(PLRU_entries[parsed_set][0]) begin
			if(PLRU_entries[parsed_set][2]) begin
				target_way <= 3;
				PLRU_entries[parsed_set][0] <= 0;
				PLRU_entries[parsed_set][2] <= 0;
			end
			else begin
				target_way <= 2;
				PLRU_entries[parsed_set][0] <= 0;
				PLRU_entries[parsed_set][2] <= 1;
			end
		end
		else begin
			if(PLRU_entries[parsed_set][1]) begin
				target_way <= 1;
				PLRU_entries[parsed_set][0] <= 1;
				PLRU_entries[parsed_set][1] <= 0;
			end
			else begin
				target_way <= 0;
				PLRU_entries[parsed_set][0] <= 1;
				PLRU_entries[parsed_set][1] <= 1;
			end
		end
		state <= MEM_REQ;
	end
end
이 외에 way가 생기면서 각 entries들에 인덱스 차원이 하나 늘어났고, 그 때문에 hit이나 empty 검사시 for 문을 이용하여 병렬적으로 접근한다는 것 외에 Set-Associative 구현 자체의 난이도는 높지 않았던 것 같다. 한 3일에서 5일동안 잡고 있었는데, 실상 하루 반나절에서 이틀만에 구현 완료한 기분이다.
앞으로는 집중해서 끝낼 일은 확실하게 끝내자!
L2 Cache
dual-ported L2 Cache
처음부터 dual port로 하려고 한 건 아니지만, 이것저것 생각하다가 가장 깔끔한 해결책이 dual port라고 생각해 약 7시간만에 완성해버린 코드이다. 확실히 본 과제는 5일도 아니고 4일만에 할 수 있는 거였는데, 대략 8일 정도 걸린 것이 아쉽다. 그래도 정신차리고 후반에 속도를 내서 다행이다. 역시 생각을 열심히 해보고 구현을 하든가 하도록 노력해보자.
state는 다음과 같다.
1
2
3
4
5
6
7
8
    localparam IDLE        = 3'b000; // 0
    localparam HIT_CHECK   = 3'b001; // 1
    localparam EMPTY_CHECK = 3'b010; // 2
    localparam PLRU        = 3'b011; // 3
    localparam DIRTY_CHECK = 3'b100; // 4
    localparam MEM_REQ     = 3'b101; // 5
    localparam EVICT       = 3'b110; // 6
    localparam RESPOND     = 3'b111; // 7
FSM을 구현하는 state 레지스터를 state_rw, state_ro로 나누었고, PLRU관련 레지스터들도 rw, ro전용으로 나누었다.
그러니까 tag_entries와 data_entries 빼고 사실상 모든 것을 rw / ro로 나누어 편하게 구현한 것 같다.
이렇게 구현했을 때의 장점은 기존 i_cache와 d_cache를 그대로 옮겨와도 된다는 것이다.
이때 i_cache의 경우에도 d_cache와 캐시 엔트리를 공유하므로 evict state나 dirty bit 검사가 반드시 필요하다는 것이다. 이걸 놓쳐서 꽤 오랫동안 골머리를 앓았다.
그런데 교수님께 이것저것 질문하면서 해당 듀얼포트 구현에 대해 얘기했다가 듀얼포트 구성이 하드웨어적으로 코스트가 많이 든다는 것을 알았다. 이후 교수님이 싱글포트로 합쳐서 구현해보라고 하셔서 그렇게 해보기로 했다.
single-ported L2 Cache
처음에는 port 의 개념 자체가 헷갈려서 도대체 어떻게 바꿔야 single-ported가 되는건지 감이 오질 않았다. 그래서 삽질을 좀 하다가 나중에야 진정한 의미를 깨닫고, 거의 3분만에 코드를 고치고 실행을 완료했던 것 같다.
방법은 그냥 ro / rd 로 나뉘어있는 포트를 하나로 합치는 대신 데이터 폭을 늘려 마치 두 개의 포트가 있는 것처럼 동작하도록 했다. 이런 걸 포트 통합(port consolidation)이라고 한다는데, 올바른 방법이면 좋겠다.
뭐 나중에 알게 되겠지.
multi port
1
2
3
4
5
6
7
8
9
10
11
    // ...
    parameter WORD_SIZE   = 32,
    // ...
    input   wire    [WORD_SIZE-1:0]     l1_rw_addr_i,
    output  wire    [WORD_SIZE-1:0]     l1_rd_data_o,
    input   wire                        l1_rd_req_i,
    output  wire                        l1_rd_ack_o,
    input   wire    [WORD_SIZE-1:0]     l1_ro_addr_i,
    output  wire    [WORD_SIZE-1:0]     l1_ro_data_o,
    input   wire                        l1_ro_req_i,
    output  wire                        l1_ro_ack_o,
single port
1
2
3
4
5
6
7
8
9
10
11
12
13
14
    // ...
    parameter DOUBLE      = 64,
    // ...
    input   wire    [DOUBLE-1:0]        l1_rwo_addr_i,
    output  wire    [DOUBLE-1:0]        l1_rdo_data_o,
    input   wire    [1:0]               l1_rdo_req_i,
    output  wire    [1:0]               l1_rdo_ack_o,
    // ...
    assign l2_rdo_data = { l2_rd_data, l2_ro_data };
    assign l2_rwo_addr = { l2_rw_addr, l2_ro_addr };
    assign l2_rdo_req  = { l2_rd_req, l2_ro_req };

    assign l2_ro_ack = l2_rdo_ack[0];
    assign l2_rd_ack = l2_rdo_ack[1];