Verilog Pipelining + L1 Cache
컴퓨터구조론 수업 이후 L1 Cache 추가 구현
Intro
한양대학교 3학년 1학기에는 컴퓨터구조론이라는 수업이 있다.
말 그대로 컴퓨터구조에 대해 배울 수 있는 시간인데, 과제를 통해 Verilog를 이용하여 차례대로 ALU, Single-Cycle CPU, Multi-Cycle CPU, 그리고 Pipelining CPU를 구현해 보았다.
마지막 과제는 Pipelining CPU에 Forwading구현 및 Branch Predictor를 통합해보는 것이었는데 시간 관계상 통째로 날려먹었다.
이후 해당 수업을 맡았던 이헌준 교수님의 랩실에 학부연구생으로 들어가게 되어서 추가 과제를 수행하게 되었다.
그 과제가 바로 Pipelining CPU에 instruction cache 및 data cache, 즉 Split L1 Cache를 올려보는 것이다.
Pipelining CPU
Pipelining CPU 구현 과제에서 주어진 요구사항은 다음과 같다.
What to implement
- Divide the computation into five stages and execute multiple instructions in parallel
- Properly set the control signals over the five pipeline stages (whichever way you want)
- Predict not-taken during instruction fetch
- If the branch is taken, flush the mis-predicted instructions
- You are allowed to perform early branch resolution @ ID stage if you want
- Detect data hazard and stall
- If the CPU detects a data hazard, stall the pipeline and reexecute the ID stage (do not support data forwarding for now)
멀티사이클 CPU의 코드를 이용해 구현했으므로, 과거 코드 대비 주요 변화점은 두 가지이다.
기존에 instruction에 따라 5-stage를 유동적으로 방문 (MEM stage를 방문할 필요가 없다면 방문하지 않음)했던 것을 모든 instruction이 각 5-stage를 한 번씩 거치도록 수정했고, 각 stage 사이에 latch를 추가해 파이프라이닝의 핵심 기능을 구현했다.
이때 발생하는 RAW hazard를 detect하고 올바르게 stall하는 것, 그리고 Control hazard를 detect하고 성공적으로 flush 후 다시 파이프라이닝 연산을 시작하는 것이 주요 포인트가 되겠다.
여기서 latch를 각 스테이지 사이마다 선언했는데, 필요로 하는 reg 수가 너무 많아서 이게 맞나 싶기도 했다.
1
2
3
4
5
6
7
8
9
10
11
12
// Split the instructions
// Instruction-related wires
reg     [31:0]      inst;
reg     [31:0]      IF_ID_inst;
reg     [31:0]      ID_EX_inst;
reg     [31:0]      EX_MEM_inst;
reg     [31:0]	    MEM_WB_inst;

reg     [5:0]       opcode;
reg     [5:0]       ID_EX_opcode;
reg     [5:0]	    EX_MEM_opcode;
/// ...
Pipelining CPU + Split L1 Cache
기본으로 마련되어 있는 i_cache, d_cache 템플릿으로 구현을 시작했다.
기본적인 구조는 기존 Pipelining 코드를 따랐고, 여기에 Instruction Memory Stall을 의미하는 IMS와 Data Memroy Stall을 의미하는 DMS라는 신호를 추가하여 메모리를 가져오는 동안 올바르게 Stall될 수 있도록 해주었다.
기존 i_cache, d_cache 템플릿은 16비트 워드 사이즈를 가지며 4바이트 aligned 되어있지 않았는데, 이를 꼼꼼히 수정하지 못해 초반에 삽질을 좀 했다.
최종적으로 워드 사이즈를 올바르게 설정하고, 특히 오프셋 또한 기존 2비트에서 aligned를 위해 4비트로 늘리면서 해당 문제는 해결할 수 있었다.
Instruction Cache
각 파라미터 사이즈는 다음과 같다.
1
2
3
4
5
localparam OFST_SIZE =  4; // block offset size
localparam SET_SIZE  =  4; // set index size
localparam TAG_SIZE  = 23; // tag size
localparam MDAT_SIZE =  1; // metadata = valid bit
localparam TENT_SIZE = 24; // tag entry size = tag + metadata
파싱은 다음과 같이 했다.
1
2
3
assign parsed_tag    = cpu_addr_i[31:8];
assign parsed_set    = cpu_addr_i[7:4];
assign parsed_offset = cpu_addr_i[3:2];
FSM의 정의는 다음과 같이 했다.
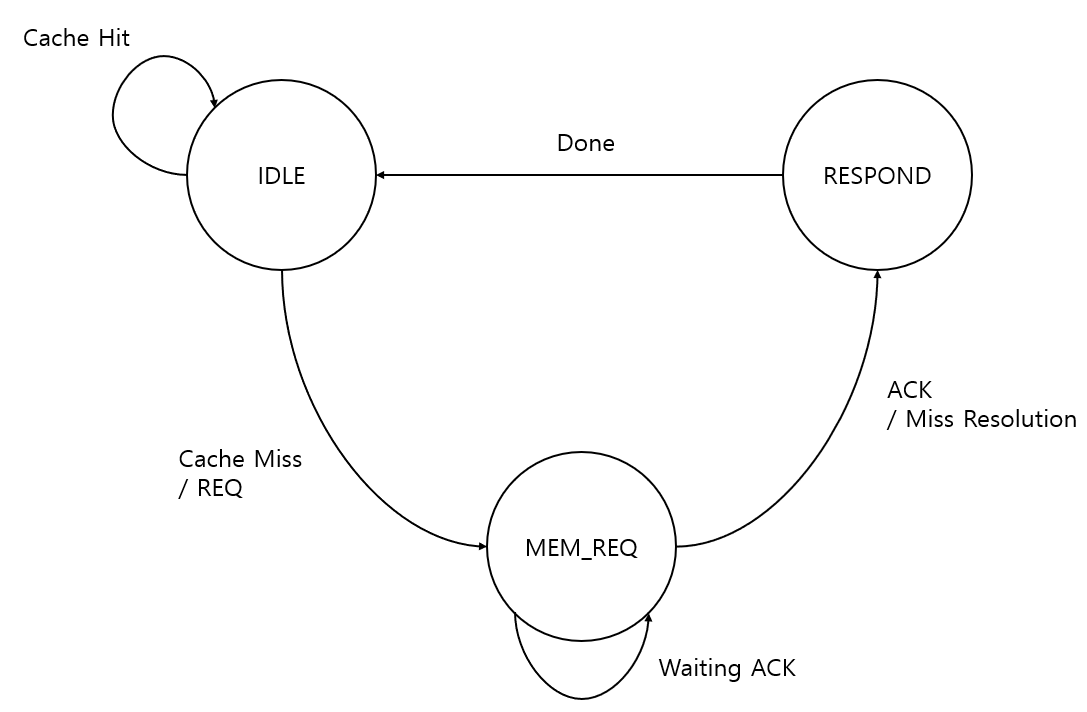
사실 코드의 구현 난이도나 동작 자체는 어렵지 않으나 역시 verilog답게 handshaking 관련 신호들의 타이밍을 조절하는 게 쉽지 않았다. 그래도 계속 하다보면 지금보다 훨씬 쉽게 느껴지리라 믿는다.
원래는 RESPOND state 없이 바로 IDLE state로 가는 구조였으나 위에서 언급한 신호들의 타이밍 조정 떄문에 RESPOND state를 추가해서 한 사이클이 딜레이되게 되었다.
이것도 사실 전략적으로 접근한 것이 아니라 주먹구구식으로 될 때까지 이것저것 시도해보며 나온 결과이기에 분명히 더 잘, 깔끔하게 하는 방법이 있을 것 같다. 다음 과제에 시간이 되면 다시 도전해보자.
Data Cache
Instruction Cache가 READ-ONLY 채널을 이용하기 때문에 비교적 간단하게 구현된 반면 Data Cache는 보다 조금 더 복잡하다.
파라미터 사이즈는 다음과 같다.
1
2
3
4
5
6
// cache parameters
localparam OFST_SIZE =  4;  // block offset size
localparam SET_SIZE  =  4;  // set index size
localparam TAG_SIZE  = 23;  // tag size
localparam MDAT_SIZE =  2;  // metadata = valid bit + dirty bit
localparam TENT_SIZE = 25;  // tag entry size = tag + metadata
instruction cache의 경우 메타데이터 사이즈가 valid bit 하나만 포함하는 1비트였는데, write가 가능한 data cache의 경우 dirty bit까지 포함한 2비트가 되었음을 알 수 있다.
FSM은 instruction cache를 기반으로 하나의 state를 더 추가하였다. 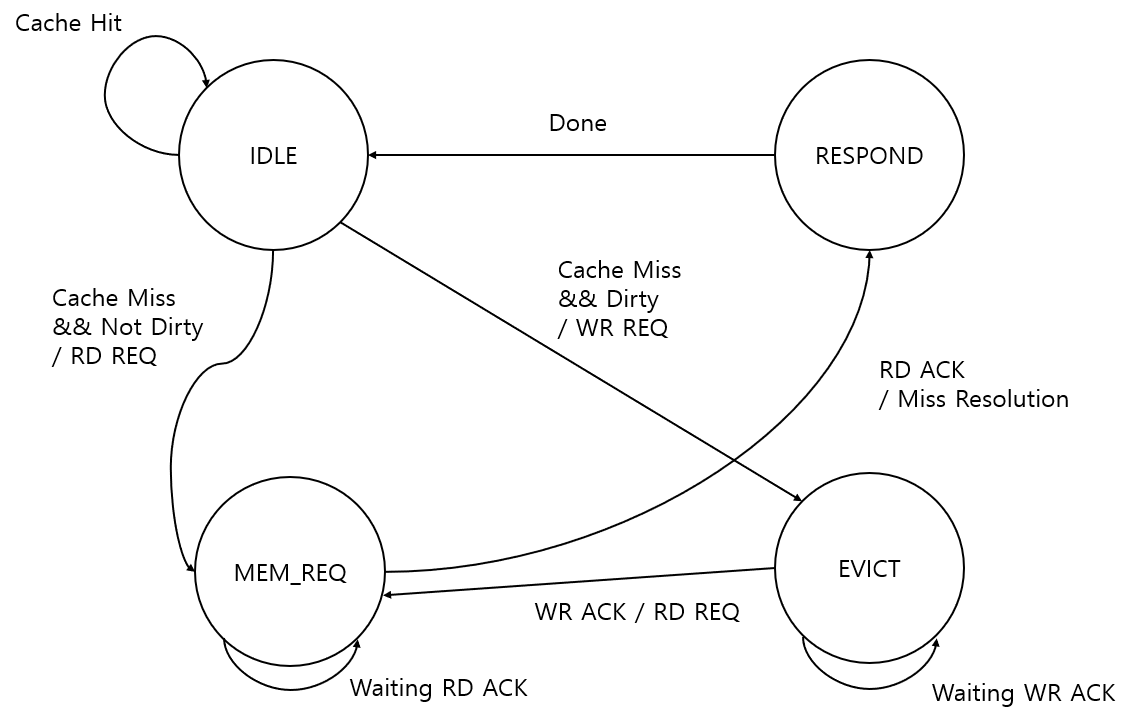
Write-Back / Write-Allocate 방법을 사용했기 때문에, dirty bit가 1인 캐시 블럭을 evict하게 되면 그 때 메모리에 써주었다.
기본적으로 data cache도 instruction cache와 같은 구조를 따랐기 때문에 크게 특이사항은 없었다.
CPU
가장 많이 고생했던 곳은 CPU에 instruction cache와 data cache를 통합하는 것이었는데, 기존 코드에서 추가적인 stall이 생겨 instruction cache와 data cache 그리고 CPU 사이의 타이밍을 조절하는 것이 어려웠다.
또 기존에 Control Hazard(jump, jr, branch)와 Data Hazard(RAW)를 관리하고 있었는데, IMS(Instruction Memory Stall)과 DMS(Data Memory Stall)를 추가하면서 추가적인 Stall이 생겨 실행 흐름이 이상해지는 현상이 있었다.
원래는 jump 조건을 만족하지 않으면 jr 검사, 또 그 다음에 branch, 그리고 마지막으로 RAW를 검사하도록 코드를 짰는데, IMS와 DMS를 추가하면서 파이프라이닝의 특성상 RAW와 DMS 둘 중 하나만 detect하면 안 된다는 것을 깨달았다. 그래서 else if를 지우고 둘의 조건을 한 번에 검사하도록 바꾸게 되었다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// 예시
// ...
if(!IMS && (jump || jr || zero)) begin
	// flush IF_ID
	IF_ID_PC        <= 0;
	IF_ID_PC_next   <= 0;
	IF_ID_inst      <= 0;
end
else if(DMS || IMS || RAW) begin
	// stall IF_ID
	IF_ID_PC        <= IF_ID_PC;
	IF_ID_PC_next   <= IF_ID_PC_next;
	IF_ID_inst      <= IF_ID_inst;
end
else begin
	IF_ID_PC        <= PC;
	IF_ID_PC_next   <= PC_next;
	IF_ID_inst      <= icache_rd_data;
end
// ...
latch 별로 조건을 나눠놓아서 이런 식으로 구현할 경우 우선순위에 있어 문제가 없다. 특히 IMS와 Control Hazard 사이의 우선순위 및 타이밍 조정이 잘 이루어져야 했다.
Outro
뭔가 설명을 대충 적어놓은 것 같지만 나의 소중한 뇌가 이 정도 정보로도 추후 충분한 인사이트를 얻을 기억력이 있기를 바라며 마치겠다.
추가로 이 과제를 통해 같은 reg에 두 번 이상의 논블로킹(<=)을 지양해야 한다는 것을 확실하게 알았다.
앞으로는 베릴로그를 더 잘 짜보자!